架构
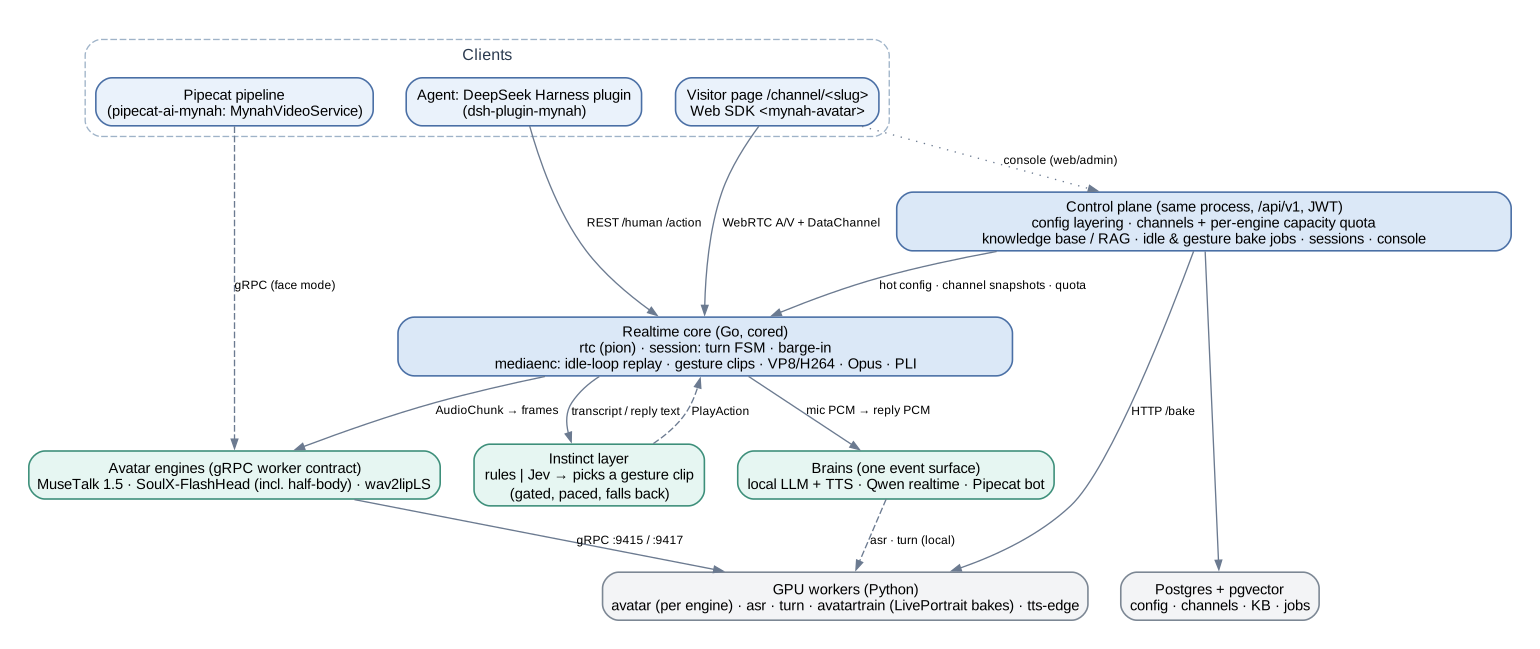
Mynah 按分层搭建,相邻两层之间只有一份接口契约。因此每一层都可以单独替换:形象引擎不关心对话由哪个大模型驱动,大模型也不关心口型由哪个引擎渲染,管理控制台只和控制平面打交道,不直接碰推理进程。
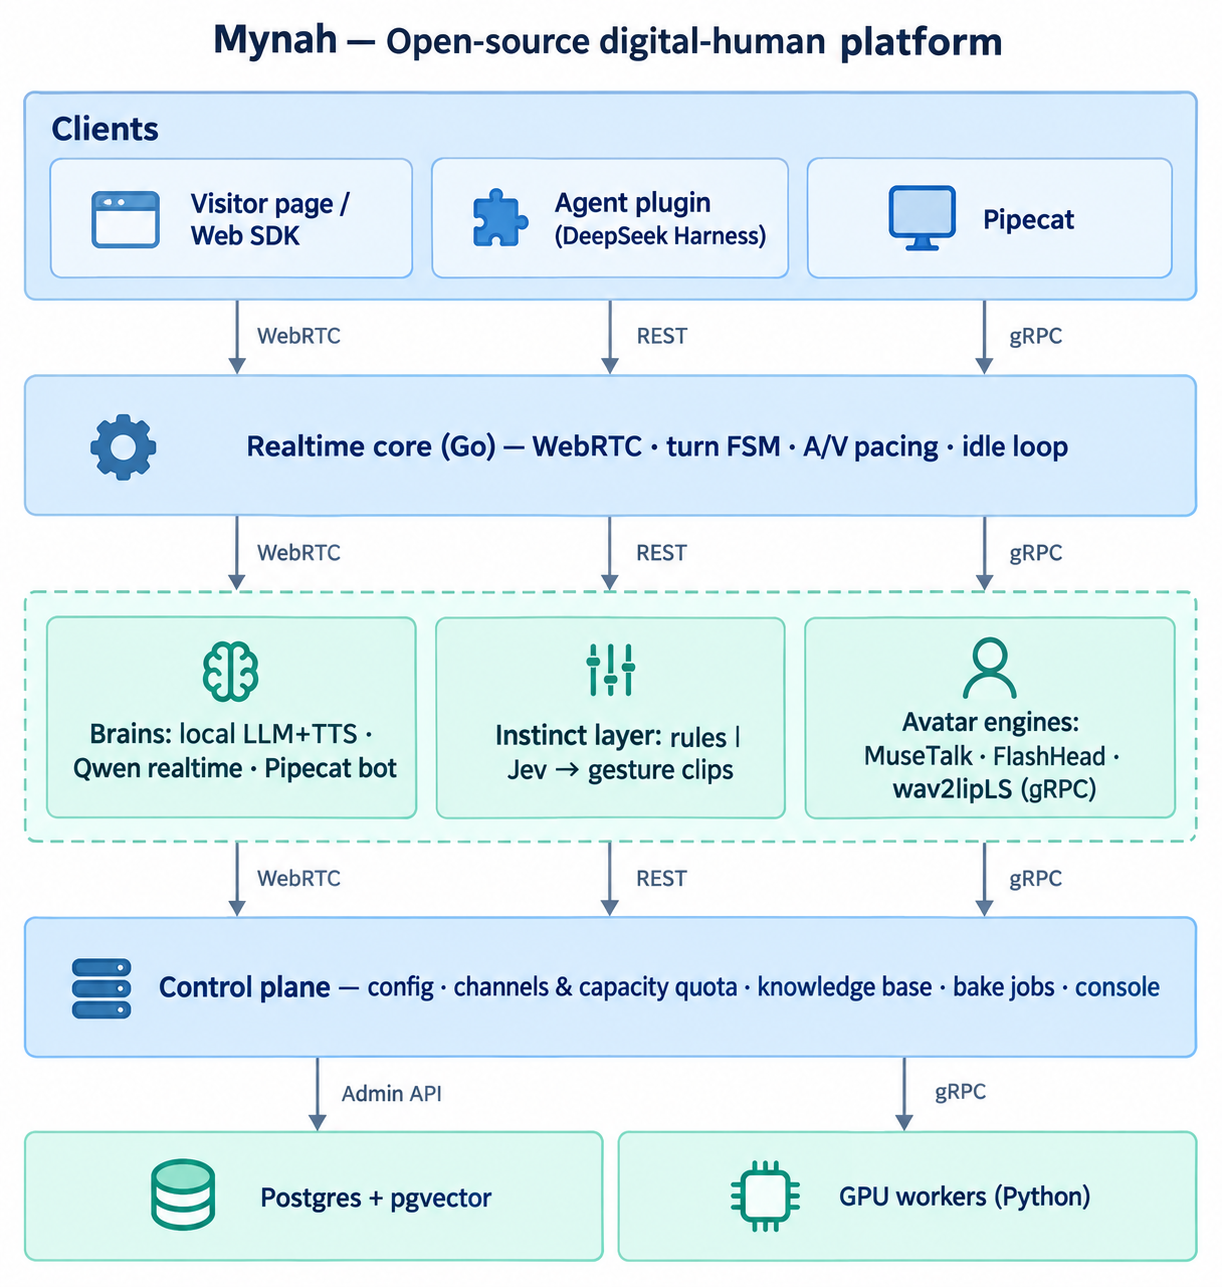
 ┌──────────────────────────────────────────────────────────────────────────┐
 │  客户端           访客页 /channel/<slug> · Web SDK <mynah-avatar>          │
 │                   Agent:DeepSeek Harness 插件 · Pipecat(Mynah 当脸)     │
 └───────────────▲──────────────────────────────────────────────▲──────────┘
     WebRTC(音视频 + DataChannel)                     REST /human /action …
 ┌───────────────┴──────────────────────────────────────────────┴──────────┐
 │  实时核心(Go,cored)                                                    │
 │   rtc(pion) → session:轮次状态机 · 说话态 · 打断                         │
 │   mediaenc:待机循环回放 · 动作片段 · VP8/H264 · Opus · 关键帧(PLI)        │
 │   ┌───────────────┐  ┌──────────────────────┐  ┌───────────────────────┐ │
 │   │ 大脑          │  │ 本能层(System One) │  │ 数字人引擎            │ │
 │   │ 本地 LLM+TTS  │  │ 规则 | Jev           │  │ gRPC worker 契约      │ │
 │   │ Qwen 实时     │  │ 大脑说话时挑一个动作 │  │ MuseTalk · FlashHead  │ │
 │   │ Pipecat 机器人│  │                      │  │ wav2lipLS ·(你的)   │ │
 │   └───────────────┘  └──────────────────────┘  └───────────────────────┘ │
 └───────────────▲──────────────────────────────────────────────▲──────────┘
     管理 API /api/v1(JWT)                                   gRPC / HTTP
 ┌───────────────┴──────────────────┐   ┌─────────────────────────┴──────────┐
 │  控制平面(同一进程)             │   │  Worker(Python,GPU)              │
 │   配置分层 · 频道 + 并发配额 ·   │   │  avatar(按引擎)· asr · turn       │
 │   知识库/RAG · 烘焙任务 ·        │   │  avatartrain:待机与动作烘焙        │
 │   会话监控 · 控制台              │   │  (LivePortrait)· tts-edge         │
 └───────────────┬──────────────────┘   └─────────────────────────────────────┘
                 ▼
         Postgres + pgvector(配置、频道、知识库、任务)
各层
| 层 | 位置 | 负责什么 | 与下一层的契约 |
|---|---|---|---|
| 客户端 | web/user(访客页)、web/sdk(<mynah-avatar>)、dsh-plugin-mynah、pipecat-ai-mynah | 播放流、采麦、字幕、动作条、Agent 工具 | WebRTC /offer,REST(/human、/action、/interrupt_talk),DataChannel 事件 |
| 实时核心 | internal/rtc、internal/session、internal/mediaenc、internal/signaling | 每个访客一个 Session:对等连接、对话状态机(idle → listening → thinking → speaking)、打断、音视频配速、待机回放、关键帧处理(PLI) | 从大脑取音频,推给引擎 worker,把帧转给浏览器 |
| 大脑 | internal/llm + internal/tts(本地)、internal/qwenrt(Qwen 实时)、internal/pipecatrt(Pipecat) | 把访客说的话变成回复语音。三者对 session 暴露同一套事件面(ServeEvents:用户文本、回复开始/增量/结束、回复 PCM、打断) | 双向 16 kHz PCM |
| 本能层 | internal/instinct | 快速决策模型(规则或 Jev)看着转录,从形象的动作片段里挑一个;有门控、有节奏、失败回退规则、永不在关键路径上 | 与访客动作条共用 PlayAction |
| 数字人引擎 | workers/avatar/*,契约在 proto/avatarengine | 由音频生成口型帧:MuseTalk 1.5(烘焙形象)、SoulX-FlashHead(单张肖像,含半身贴回)、wav2lipLS | gRPC 双向流:AudioChunk 进,编码后的 VideoFrame + Opus AudioFrame 出,Interrupt,SetAction |
| 控制平面 | internal/control、internal/config、internal/channel、internal/knowledge、internal/avatarbake、internal/store | JWT 保护的管理 API;热配置;可发布频道与按引擎的并发配额;知识库 + RAG;待机/动作烘焙任务;会话监控 | Postgres;控制台(web/admin)只是这套 API 的客户端 |
| Worker | workers/{avatar,asr,turn,avatartrain,tts-edge} | 稳定契约之后的 GPU 推理,各自独立容器 | gRPC(avatarengine、asr、turn)与 HTTP(/bake、/train) |
一次语音轮次的完整数据流
- 浏览器麦克风 → WebRTC Opus →
session.listenMic*→ ASR worker 解码(本地模式顺带转写)。 - 判轮次:本地 Smart Turn,或由大脑自己的 VAD 决定(Qwen 的
server_vad/smart_turn、Pipecat)。 - 大脑产出回复文本与语音:本地 = LLM 流式 → 按句切 → TTS;Qwen = 语音到语音;Pipecat = 机器人管线做什么都行。无论哪种,session 拿到的都是
OnReplyDelta(字幕)和OnPCM(16 kHz 回复音频)。 - 回复 PCM → 引擎 worker(
AudioChunk)→ 口型帧回来 →mediaenc配速送上 WebRTC 轨道,说话开始和访客 PLI 时强制关键帧。 - 与此同时本能层在问"哪个动作合适";置信的选择在这句话说完后播(形象空闲时则立刻播)。
- 说话结束 → 轨道在关键帧处切回烘焙的待机循环;worker 释放(待机不占 GPU)。
状态放在哪
- 配置分层:
默认值 < 启动参数 < 数据库;控制台写数据库层,标记为热的配置组对新会话立即生效(internal/config)。 - 频道在发布时冻结快照(人设、大脑、音色、形象),控制台后续修改不影响在线频道,重新发布才生效。
- 并发按引擎记账:启用频道的并发之和必须放得进其形象所需引擎的 worker 数(
internal/control/quota.go);控制台展示配额,满了提示换位。 - 形象素材(待机循环、动作片段、半身画布)一次烘成文件并按形象注册;会话只回放,不重新生成。
扩展点
| 想做什么 | 动哪里 |
|---|---|
| 加一个口型引擎 | 写一个讲 proto/avatarengine 的 worker,在 internal/avatarengine 登记标签 |
| 加一个大脑 | 像 pipecatrt 一样实现 cloudConn(internal/session/qwen.go),加一个 brain.mode |
| 加一个本能决策来源 | 实现 instinct.Provider(两个方法) |
| 加一个动作 | 烘:POST /api/v1/avatars/bake {kind:"action", action, motion_ref} |
| 加一个管理功能 | 写一个 AdminExtension(core/extension.go)挂进控制平面 |
| 让 Agent 驱动 | REST /human /action 或 dsh 插件;Pipecat 侧用 MynahVideoService |
我们坚持的设计规则
- 契约优先于引用。 worker、大脑、客户端能替换,是因为唯一的耦合是一份 proto 或一个 HTTP 形状。
- 没人说话时烘焙,不生成。 待机和动作都是预渲染;正在听的会话 GPU 开销为零。
- 说话的模型不负责动作。 语音来自大脑,动作来自本能层,画面来自引擎——三个时间尺度,三个组件。
- 出问题就降到更便宜的一档。 Jev → 规则;云端 VAD → 本地;半身 → 单脸;能力缺失只会降级,不会卡住一轮对话。
精确连线(Graphviz 源文件:docs/diagrams/architecture.dot)