TTS 三档:EdgeTTS → Qwen3-TTS → 云端
Mynah 和 TTS 之间只有一个契约:OpenAI 兼容的 POST /v1/audio/speech,流式返回 24kHz 16 位 PCM,外加 GET /v1/audio/voices。凡是说这套话的都能接。仓库自带三档都说这套话。
| 档 | 费用 | GPU | 音色克隆 | 首包延迟 | 适合 |
|---|---|---|---|---|---|
| EdgeTTS(默认) | 免费 | 不要 | 否 | 约 0.3–0.6 秒,看外网 | 第一天、演示、能联网的触摸屏 |
| Qwen3-TTS(vLLM-omni) | 自己的卡,约 3GB | 要 | 是 | 本地约 0.3 秒 | 离线部署、品牌专属音色 |
| 云端 key | 按字符计费 | 不要 | 看厂商 | 看厂商 | 没显卡,或本来就在付费 |
还有第四条路绕开 TTS:Qwen 云端实时大脑(端到端语音)。它用一个模型替掉 ASR + LLM + TTS,公开演示频道就跑的它。演示站实测:请求到云端首包音频 0.37–0.52 秒,到第一帧带口型画面 0.73–1.07 秒。
EdgeTTS(默认)
tts-edge 容器把微软 Edge 的神经音色包成上面的契约。不下载任何东西,只用 CPU,需要能访问微软的外网。音色 id 形如 zh-CN-XiaoxiaoNeural;控制台把推荐音色置顶并缓存全量列表。语速有效,风格指令忽略。
# .env
TTS_URL=http://127.0.0.1:8091
VOICE=zh-CN-XiaoxiaoNeural
Qwen3-TTS(有显卡时的最佳实践)
docker compose --env-file .env.prod -f docker-compose.full.yml --profile qwen-tts up -d tts # 先停 tts-edge,同一个端口通过 vLLM-omni 以同一契约提供 Qwen3-TTS CustomVoice。多出音色克隆:在控制台上传 10–30 秒参考音频,自动转写,新音色出现在所有地方。每个音色有种子保证句间音色一致;风格指令如"更沉稳"可用。显存在数字人引擎之外预留约 3GB。
云端厂商
TTS_URL 指向任何实现了该契约并支持 PCM 流式的服务。围绕开源 Qwen3-TTS 权重的自托管封装(如 Qwen3-TTS-X)可以,若干 OpenAI 兼容网关也可以。只回 MP3 文件或只有 SDK 的厂商需要一个小适配层;TTS 音色契约页写清了 cored 到底要什么,适配层一页纸就够。
切档
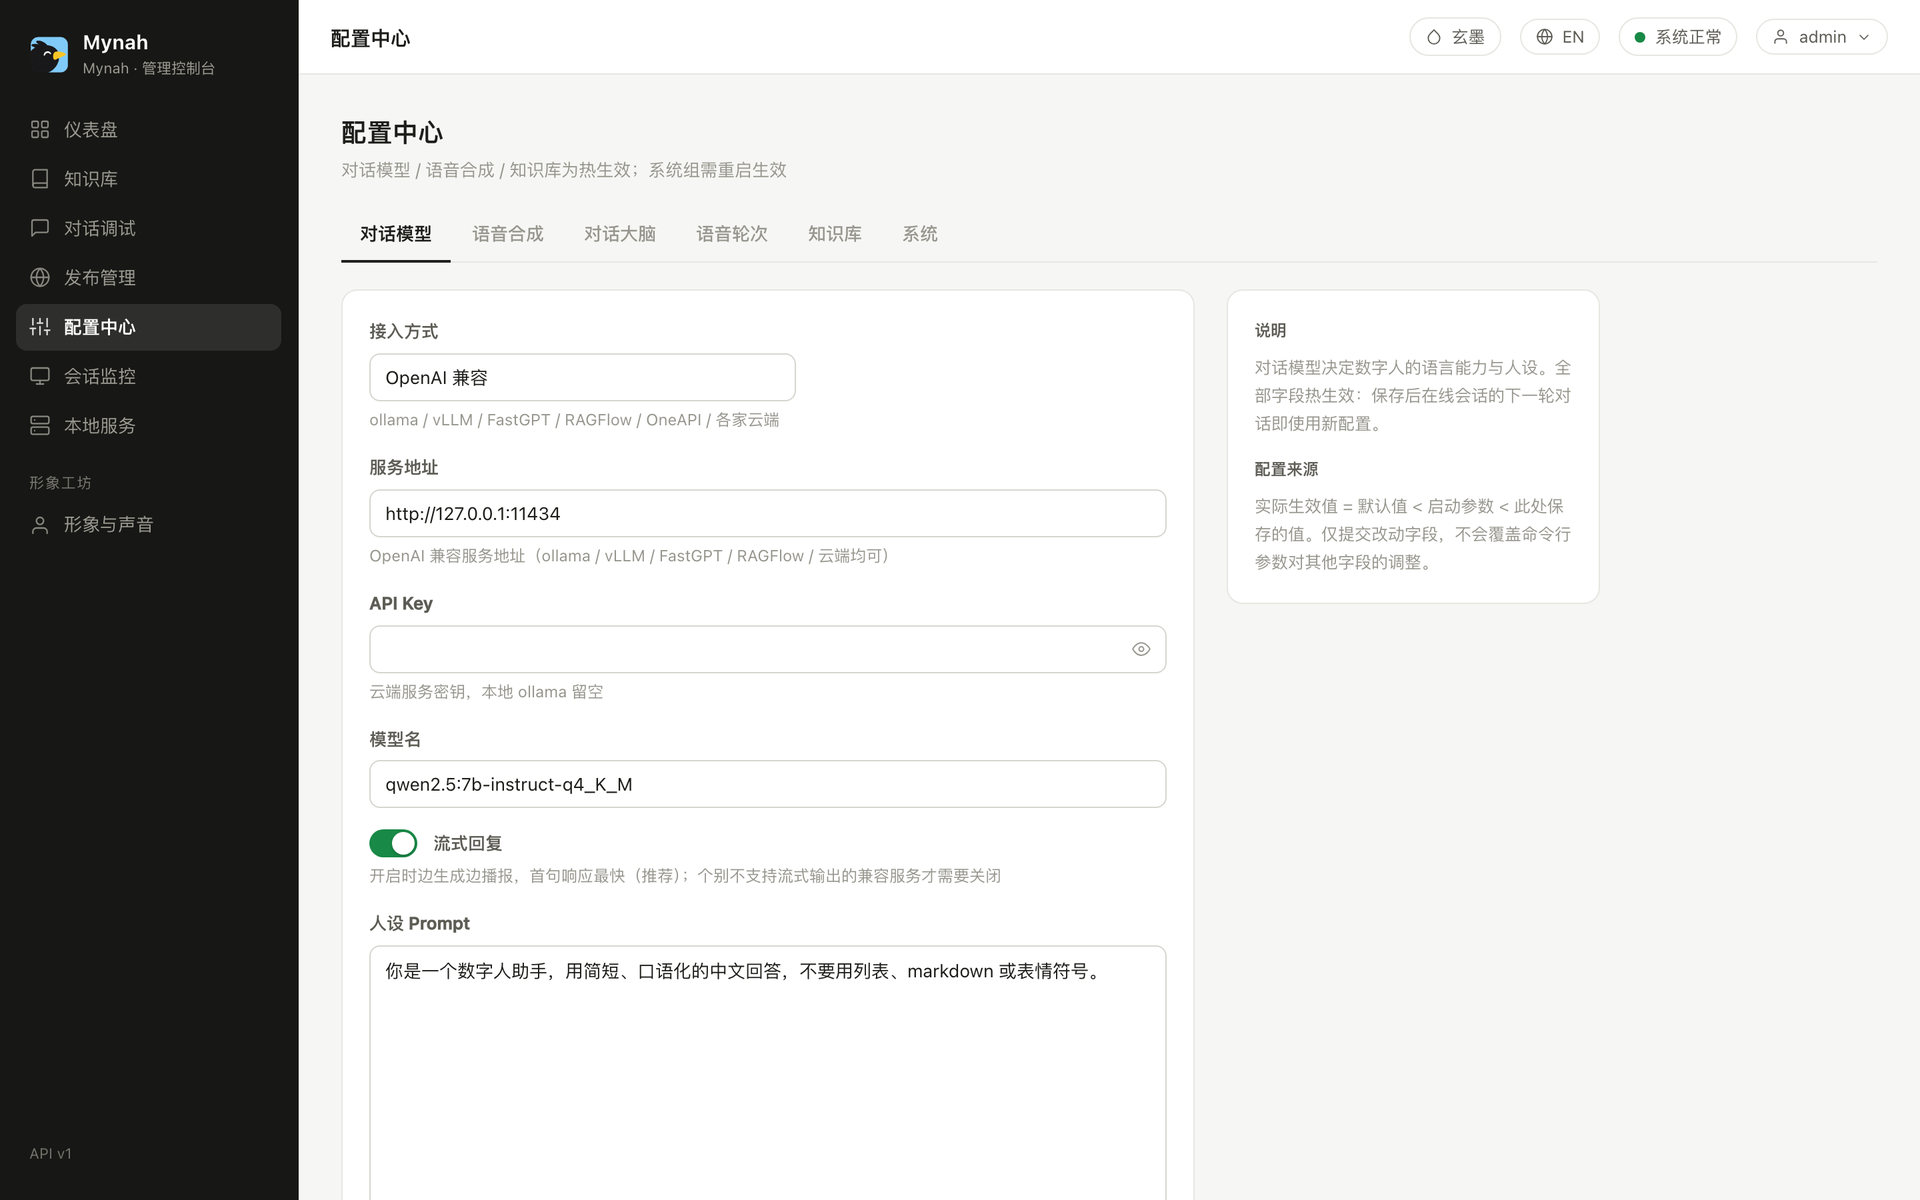
配置中心 → TTS:改 base_url 和 voice,点试听,保存。新会话用新的;进行中的会话用旧的说完。频道保留发布时的音色,直到重新发布。
Qwen 云端实时大脑
配置中心 → 对话大脑 → Qwen 实时。一个云端模型负责听、想、说;cored 仍然用返回的音频驱动数字人,口型和动作照常。音色从下拉里选云端音色。和云端轮次检测一起用时注意知识库的限制。