15 分钟跑通
三条路,按你手里有什么选。终点都一样:一个能对着说话的数字人网页,加一个管理它的控制台。
| 你有什么 | 走哪条 | 耗时 |
|---|---|---|
| 只有一台笔记本 | 路线 C:无显卡,推理走云端 | 15 分钟 |
| 一台带 NVIDIA 显卡(6GB 以上)和 Docker 的 Linux 机器 | 路线 B:Docker Compose | 20–30 分钟 |
| AutoDL / UCloud 的 GPU 实例 | 云镜像 | 镜像发布后 5 分钟 |
第一天不花钱:默认语音是 EdgeTTS(免费、只用 CPU、需要能访问外网)。之后在控制台切 Qwen3-TTS 或云端 key,不用重启。见 TTS 三档。
各部分跑在哪
浏览器 ──WebRTC──▶ cored(Go 实时核心 + 管理控制台)
                     ├─ 数字人引擎 worker(GPU:wav2lipLS / FlashHead / MuseTalk)← 可远程
                     ├─ ASR worker(SenseVoice,约 1.4GB 显存)                  ← 可远程
                     ├─ TTS(默认 EdgeTTS · Qwen3-TTS · 云端)                   ← HTTP,随处
                     ├─ LLM(ollama · vLLM · 任何 OpenAI 兼容接口)               ← HTTP,随处
                     └─ Postgres(控制台、知识库、频道)
真正需要显卡的只有数字人引擎。其它都是 HTTP 端点,指到哪都行。
路线 B:Docker Compose(有显卡)
前置:Docker 25+ 与 Compose v2、NVIDIA 驱动、nvidia-container-toolkit 并启用 CDI:
bash
sudo nvidia-ctk cdi generate --output=/etc/cdi/nvidia.yaml
docker run --rm --device nvidia.com/gpu=0 ubuntu:22.04 nvidia-smi -L   # 应列出一张卡
1. 克隆并配置
bash
git clone https://github.com/honwee/mynah.git && cd mynah/deploy/compose
cp .env.example .env
$EDITOR .env        # 填 PL_MODELS_DIR(模型目录)、AVATAR_GPU、端口
.env 里的文件路径故意没有默认值。漏填一个,docker compose up 会直接停下并点名,而不是悄悄建一堆空目录。
2. 准备模型
首启向导会检测缺什么并一键安装,下载走镜像(默认对国内网络友好;海外设 HF_ENDPOINT=https://huggingface.co):
bash
python3 ../setup/helper.py # → http://127.0.0.1:9500,每个组件点「一键安装」也可以直接跑脚本,例如最轻引擎 bash ../setup/wav2lipls.sh。
3. 启动
bash
docker compose up -d --build
docker compose logs -f cored         # 等到出现 "worker healthy"
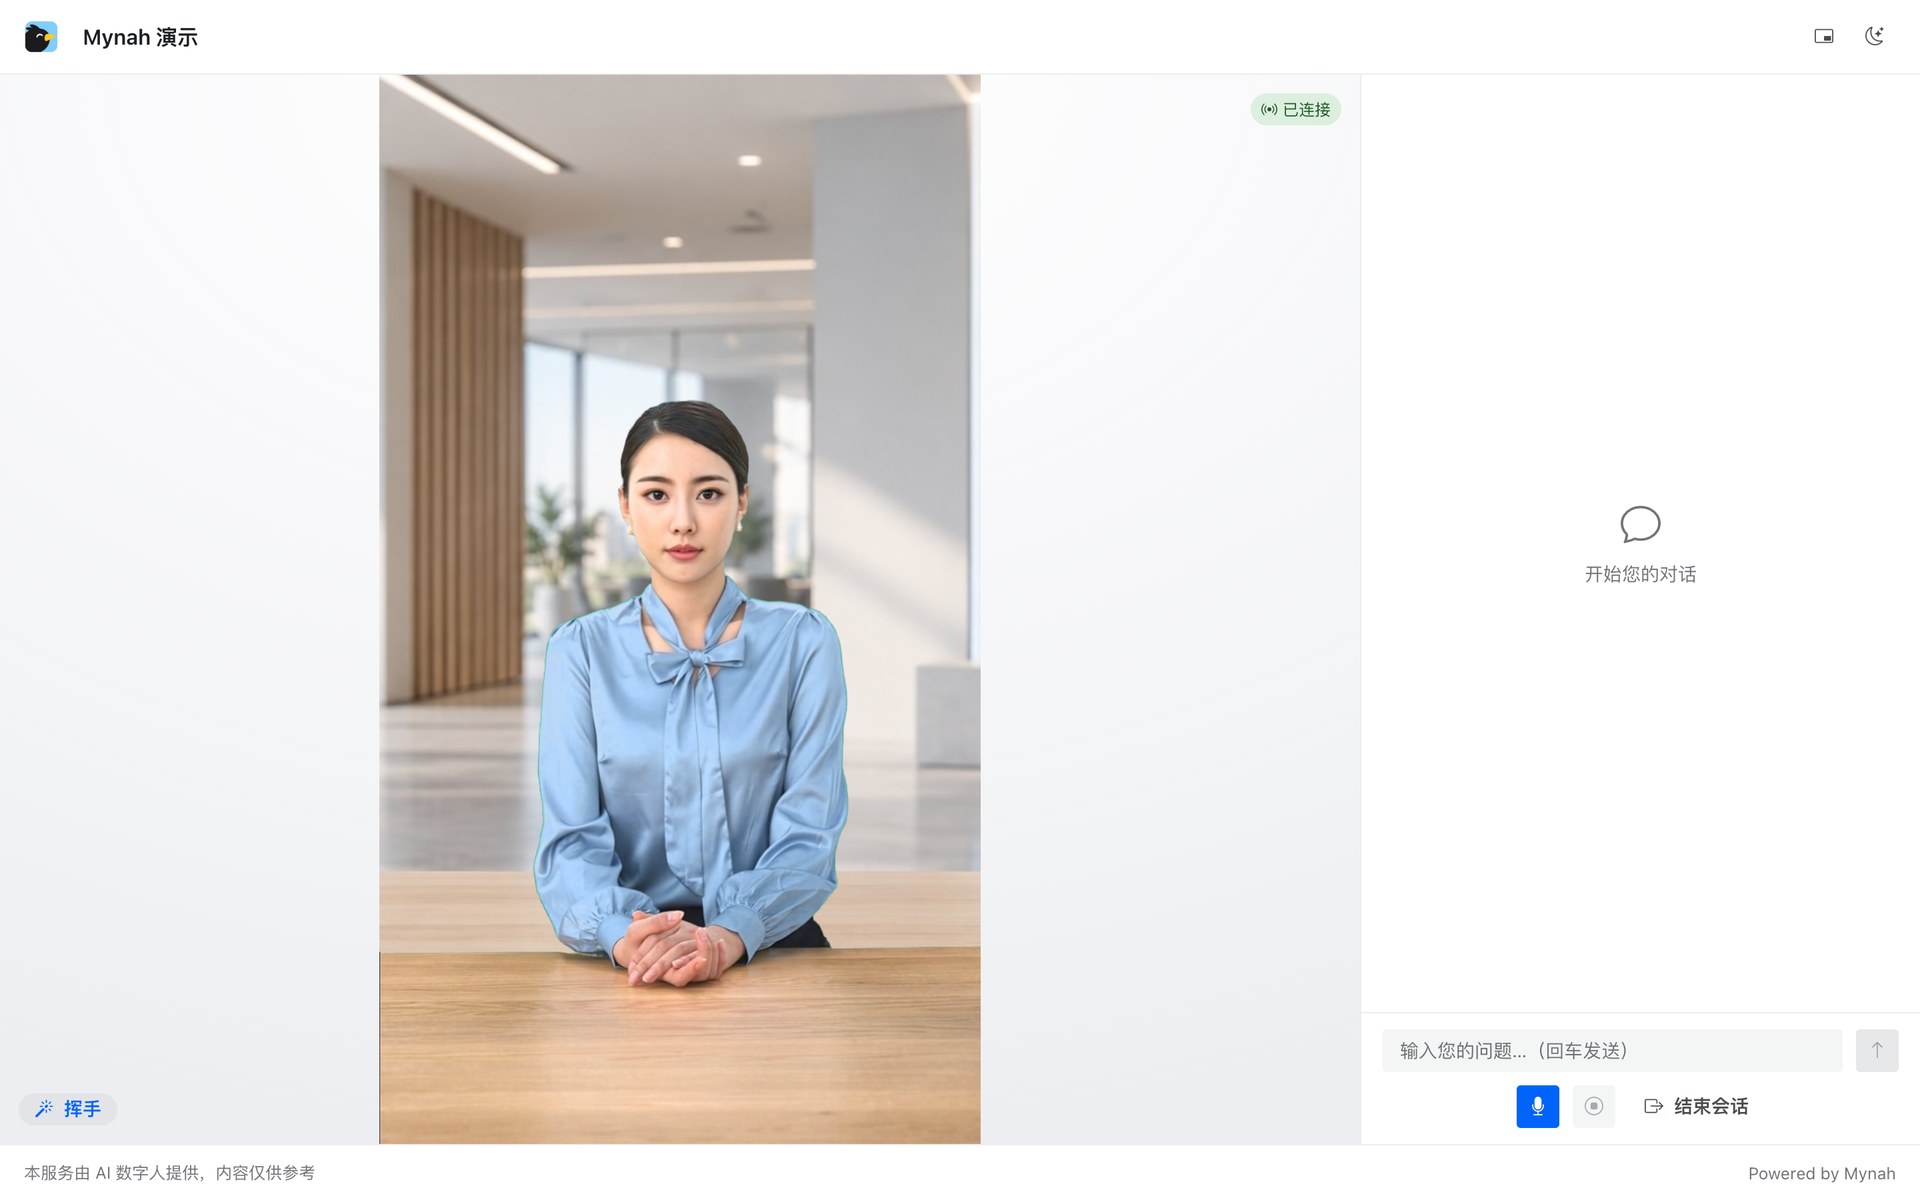
打开 https://<host>:8455/(开发栈),点 开始对话。麦克风要求安全来源,所以页面是 HTTPS,首次是自签证书;点「继续访问」,或把正式证书放进 tls/(见部署)。
4. 登录控制台
控制台在管理端口(生产栈 https://<host>:9443/)。初始管理员密码只在 cored 日志里打印一次:
bash
docker compose logs cored | grep "initial admin"首次登录会强制改密。
路线 C:无显卡
cored 和控制台放在任何机器上,重的部分指到别处:
| 组件 | 可以放哪 | 配置 |
|---|---|---|
| 数字人引擎 | 按小时租的 GPU 机器 | AVATAR_ADDR=host:port |
| LLM | 任何 OpenAI 兼容接口 | LLM_URL、LLM_MODEL、LLM_KEY |
| TTS | EdgeTTS(免费)或任何 /v1/audio/speech 服务 | TTS_URL、VOICE |
| ASR | 远程 SenseVoice worker,或改用 Qwen 云端对话大脑(它自带识别) | ASR_ADDR 或 控制台 → 对话大脑 |
数字人引擎是唯一必须有 GPU 的部分,因为嘴是它画的。最省事的来源是一台跑着云镜像的 AutoDL / UCloud 实例,把它的 host:port 填进 AVATAR_ADDR。
bash
cd deploy/compose
cp .env.example .env
# AVATAR_ADDR=1.2.3.4:9420  LLM_URL=https://api.example.com/v1  LLM_KEY=sk-...  TTS_URL=http://127.0.0.1:8091
docker compose up -d --no-deps cored tts-edge