知识库
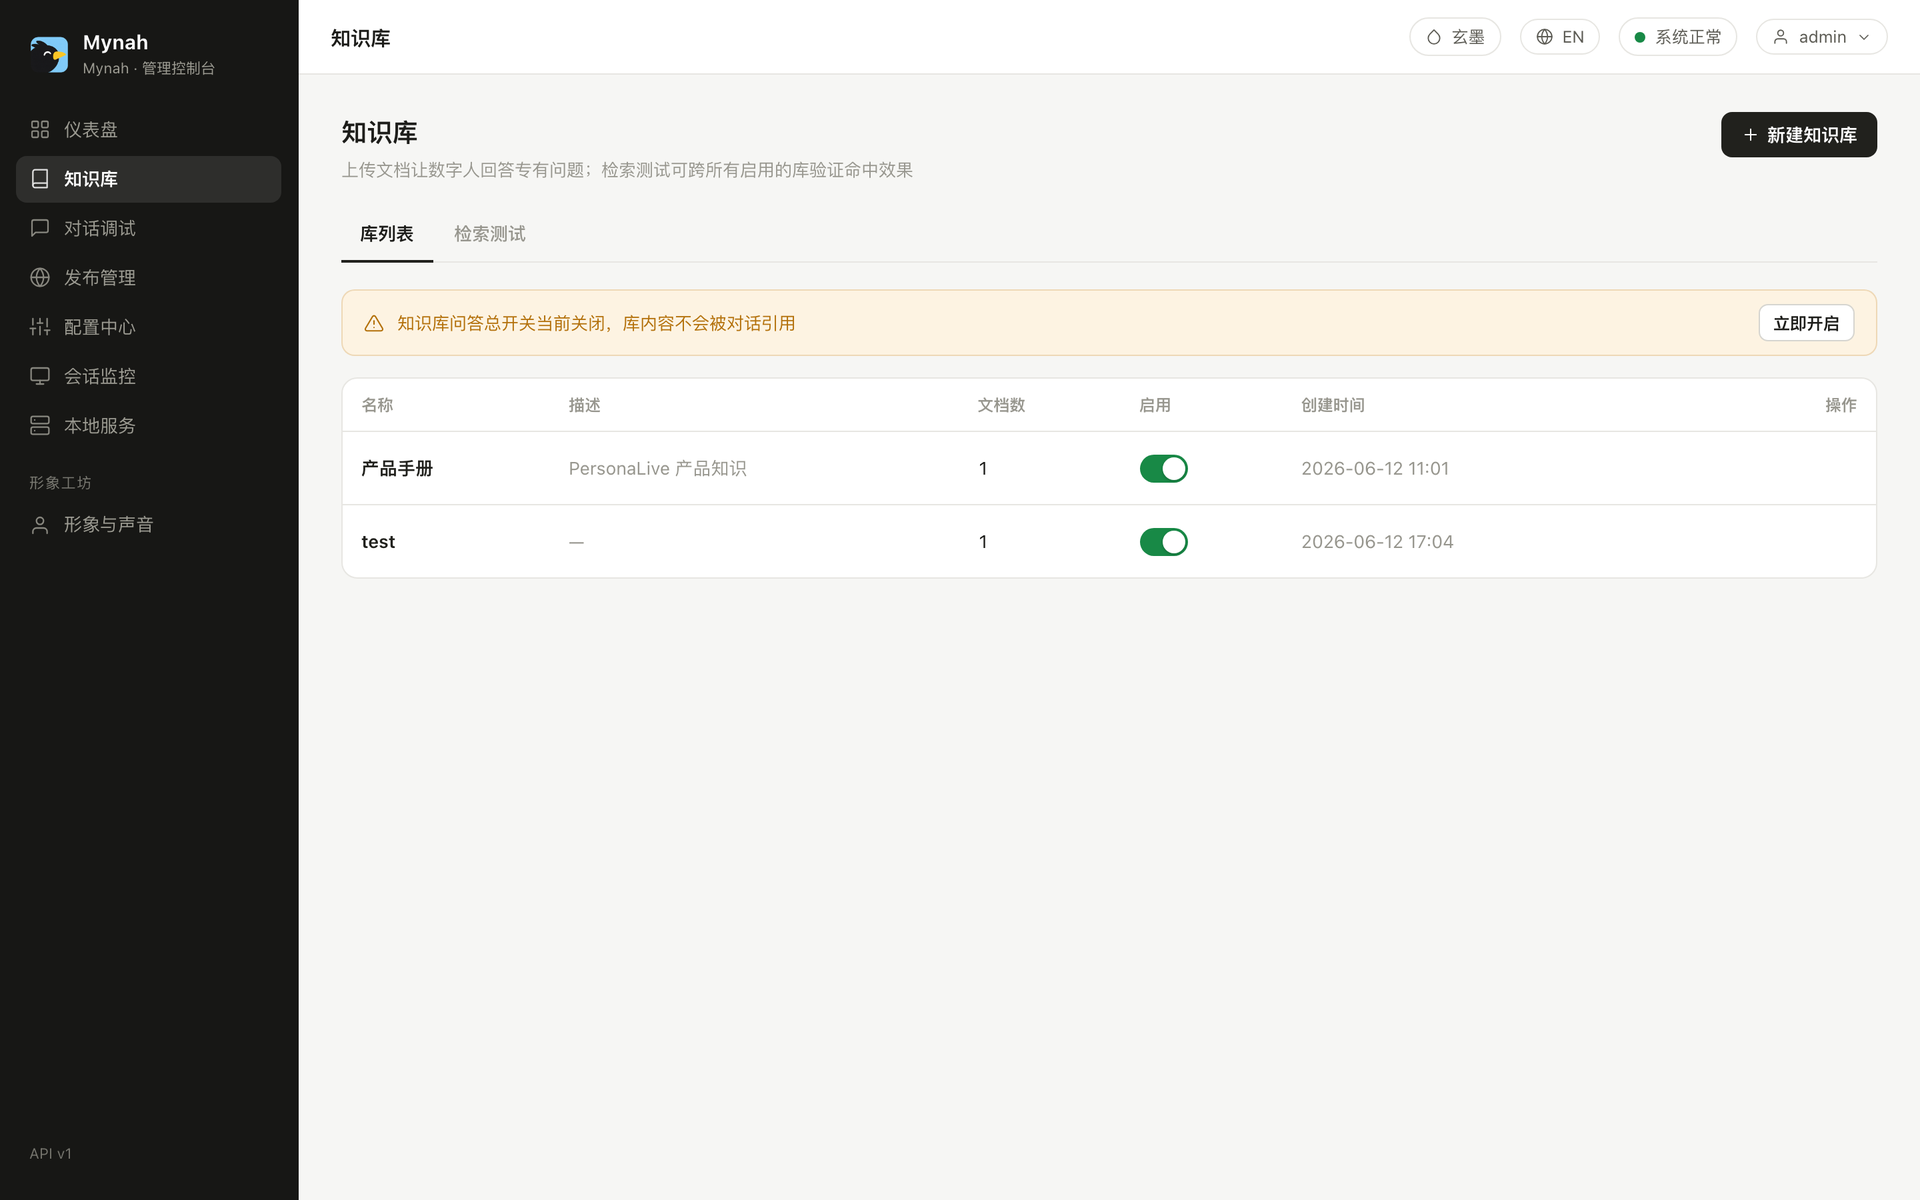
把你的资料喂给数字人,它按资料回答。链路是检索增强生成:文档切块、向量化、存进 Postgres 的 pgvector,每一轮对话把最相关的片段塞进模型上下文。
配置
- 配置中心 → RAG:
embed_url指向一个 ollama 兼容的/api/embed端点,模型bge-m3(1024 维)。你跑 LLM 用的那个 ollama 就行。 - 知识库 → 新建知识库。向量模型和维度在建库时锁死,之后换模型不会悄悄把库弄坏。
- 上传文档:
.txt和.md,单个 10MB 以内。摄取是异步的:pending → processing → ready(失败为failed并给原因)。默认 500 字一块、重叠 50 字,可调。 - 打开
rag.enabled。下一轮对话就会检索。
调参不靠猜
检索测试用线上索引跑一个问题,列出每个返回片段的分数和延迟。拿访客真正会问的问题去试,然后调:
| 旋钮 | 作用 |
|---|---|
top_k | 进提示词的片段数 |
threshold | 最低余弦相似度;无关片段漏进来就调高 |
chunk_size / chunk_overlap | FAQ 类资料切小,叙述型手册切大 |
timeout_ms | 每轮检索预算;超时就不带上下文继续,不卡住 |
可选的二阶段重排(任何标准 rerank 接口)可以在片段进模型前重新排序;设 rerank_url 和 rerank_model。
在哪条链路生效
检索发生在本地大脑链路(ASR → LLM → TTS)里。如果对话大脑切到 Qwen 云端实时(端到端语音)并且轮次检测也用云端,云端一听到问题就开始回答,没有插入片段的时机;cored 会在会话日志里打警告。知识库重要时,把轮次检测留在本地,或用本地大脑。
生命周期
- 文档改了就重传并删旧的;改了切块参数后
POST /api/v1/documents/{id}/reindex。 - 频道只冻结 RAG 参数,不冻结知识库内容,所以更新文档会立刻影响线上回答。
- 全部在 Postgres 里,
pg_dump备份。
暂时不做的
开源版不解析 PDF、DOCX、OCR,先转成 Markdown。"访客问了哪些没答上的问题"报表在路线图上。