形象与声音
形象
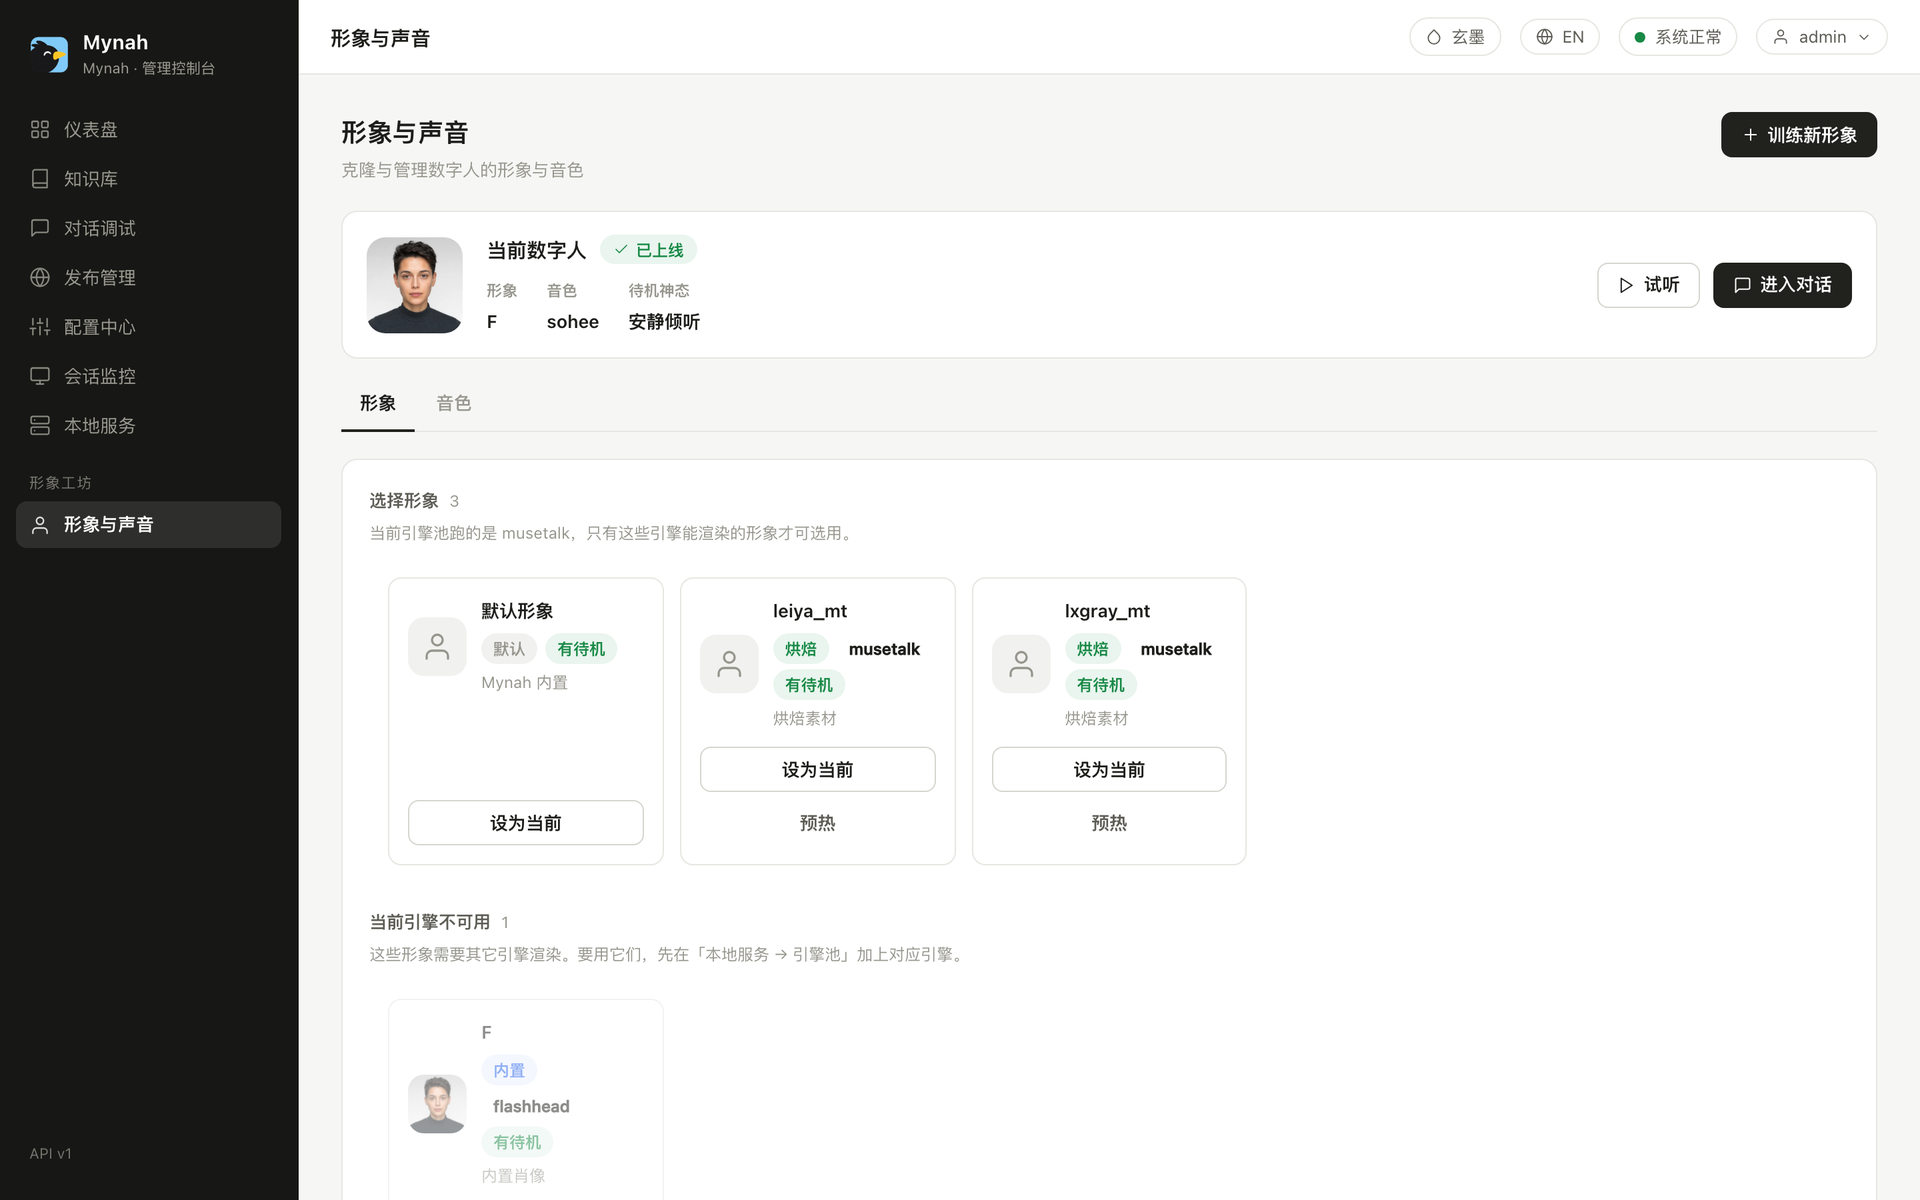
一个形象 = 一个人物外观 + 一段烘焙好的待机循环(听你说话时它在做什么)+ 可选的烘焙动作(比如挥手)。每个形象绑定一个引擎,引擎由形象派生,访客永远不会看到张冠李戴。
内置形象
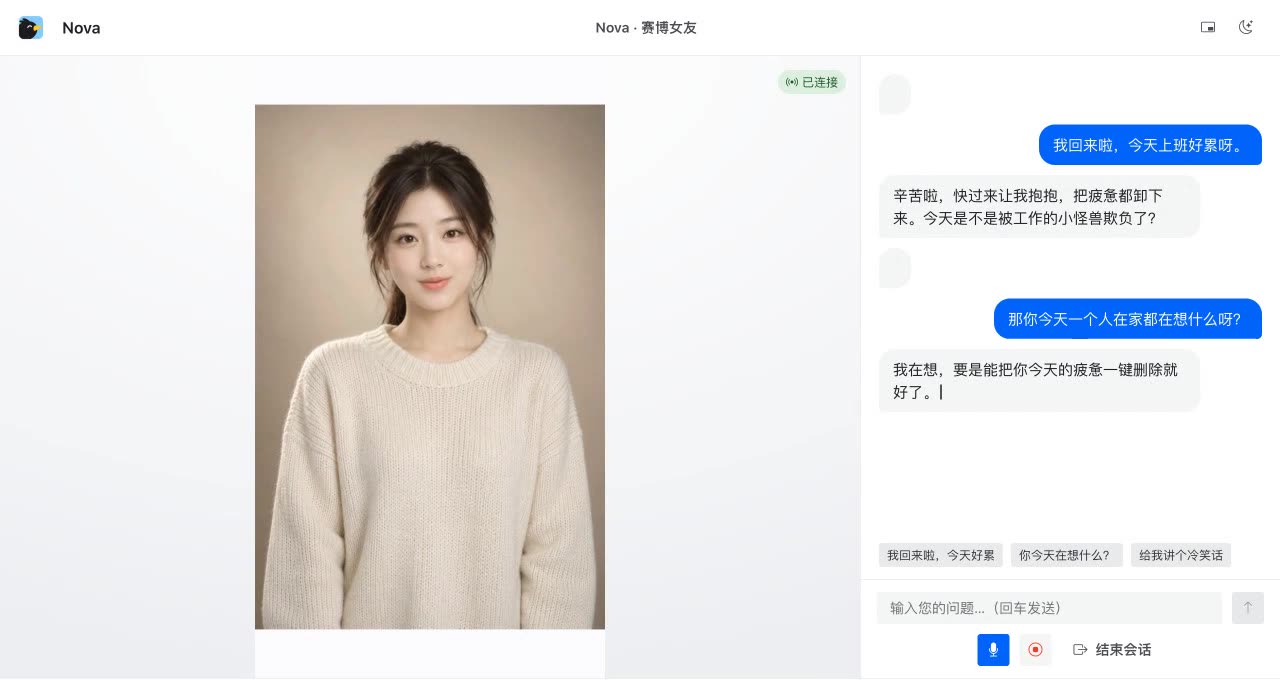
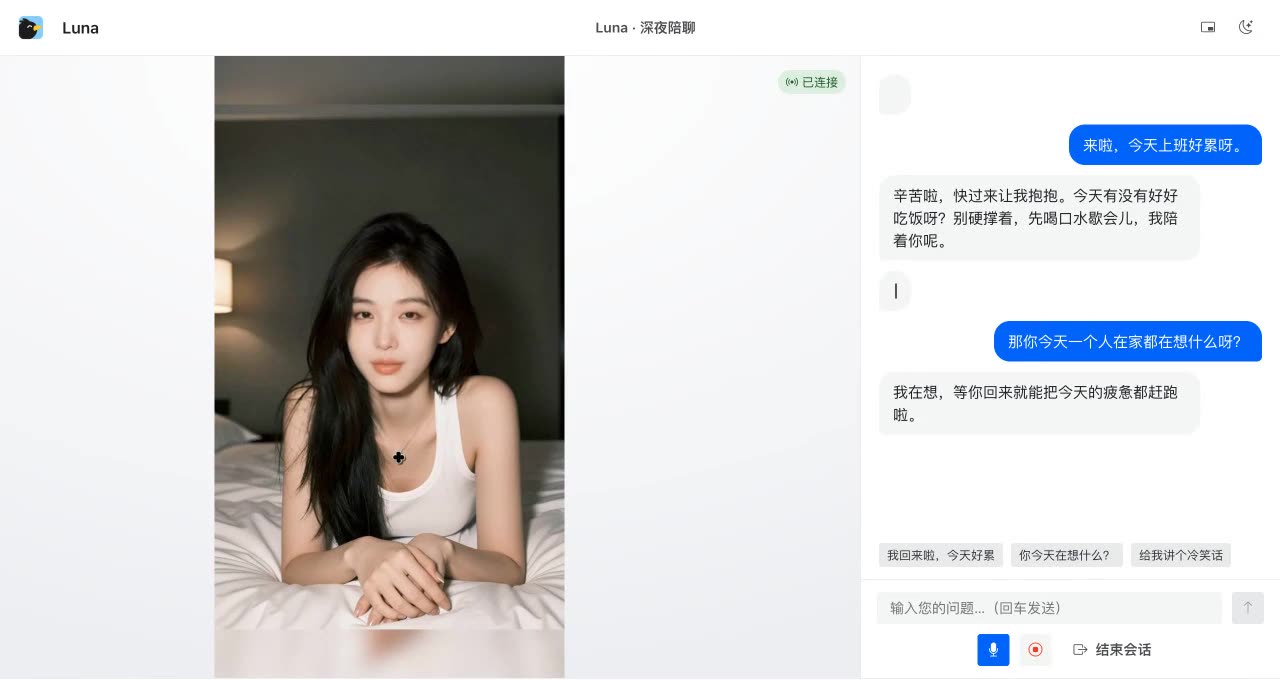
仓库自带一张默认肖像、一个烘焙好的默认形象,以及三个 FlashHead 肖像预设(F、Nova 和 Luna),第一次运行不用上传就能看到脸。FlashHead 只要一张肖像,所以加一个预设就是一个文件加 internal/avatarcatalog 里的一行。Nova 和 Luna 是以半身主持人形态发布的:FlashHead 仍然只生成 512 的人脸,worker 把它贴回 720×1280 的头到腰画布上精确的裁切框位置(workers/avatar/halfbody.py 负责画布、bbox 和贴回蒙版),一个只会头部的模型就这样变成了半身形象(Luna 是同一套做法的夜景室内版)。半身制作流程是 prepare → recrop(放宽裁切让整颗头都动)→ blend,然后在控制台烘一个待机。控制台列表里带引擎标签。设为当前后新会话立即生效。
用一段视频烘焙自己的形象
- 拍 10–20 秒对着镜头说话的视频:正面、光线均匀、嘴清晰、手别挡脸。手机拍的就行。
- 形象与声音 → 上传说话视频。管线重采样到 25fps、抽帧、按"闭嘴、正面、清晰"打分选出说话基底,用 MediaPipe 做人脸对齐(不用 InsightFace,整条链保持可商用),然后烘焙引擎专用素材。
- 同一页看任务进度;成功后形象直接出现在列表里,不用重启。
- 可选:用同一段素材再烘一段待机循环,让它在两次回答之间会呼吸眨眼,而不是定格。
烘焙是一次性的 GPU 任务,要 4–5GB 显存。池子满的时候会 OOM,控制台会提示你先停一个 worker。
授权。 训练真人形象需要本人同意。上传表单里有授权确认,政策见合规。
引擎
| 引擎 | 画面 | 显存 | 说明 |
|---|---|---|---|
| wav2lipLS 384 | 半身,嘴部清晰 | ≈ 2GB | 最轻,6GB 卡能跑 |
| MuseTalk 1.5 | 半身,平滑 | ≈ 7.7GB | 对各种素材最宽容;bbox_shift 可调嘴部开合 |
| FlashHead | 头肩特写,扩散模型 | ≈ 6.6GB | 近景保真最高 |
支持混合池:同一张卡上 MuseTalk 跑半身形象、FlashHead 跑特写,按形象派发。见硬件和引擎池设计。
预热
把形象装进 worker 要几秒。「预热」提前把频道用到的形象装好,第一位访客不会对着黑屏。
动作
形象可以携带一次性动作片段(目前有 wave 挥手)。访客页有按钮,接入方用 POST /action,Agent 用 DeepSeek Harness 插件里的 mynah_action。
声音
下拉里出现哪些音色取决于「配置中心」里的 TTS 档(见 TTS 三档):
- EdgeTTS(默认):几百个微软神经音色。列表有缓存,推荐音色置顶(
zh-CN-XiaoxiaoNeural、zh-CN-YunxiNeural、en-US-AriaNeural等)。语速可调;风格指令会被忽略。 - Qwen3-TTS(本地 vLLM-omni):内置音色,外加用一小段参考音频克隆音色。在「音色」页上传,控制台替你转写参考文本,新音色出现在所有下拉里。每个音色有独立种子,保证句与句之间音色稳定;支持风格指令("更沉稳")。
- Qwen 云端实时大脑:对话大脑切到 Qwen 实时时,语音在云端合成,音色下拉变成云端音色。
每个下拉都有「试听」,用当前配置合成一句。频道冻结发布时的音色,控制台换音色不影响线上频道,重新发布才生效。